Sólin Sólin Rís 07:28 • sest 19:08 í Reykjavík
Tunglið Tunglið Rís 18:21 • Sest 10:46 í Reykjavík
Flóð Flóð Árdegis: 07:03 • Síðdegis: 19:18 í Reykjavík
Fjaran Fjara Árdegis: 01:01 • Síðdegis: 13:16 í Reykjavík
Sólin Sólin Rís 07:28 • sest 19:08 í Reykjavík
Tunglið Tunglið Rís 18:21 • Sest 10:46 í Reykjavík
Flóð Flóð Árdegis: 07:03 • Síðdegis: 19:18 í Reykjavík
Fjaran Fjara Árdegis: 01:01 • Síðdegis: 13:16 í Reykjavík
LeiðbeiningarTil baka

Sendu inn spurningu

Hér getur þú sent okkur nýjar spurningar um vísindaleg efni.

Hafðu spurninguna stutta og hnitmiðaða og sendu aðeins eina í einu. Einlægar og vandaðar spurningar um mikilvæg efni eru líklegastar til að kalla fram vönduð og greið svör. Ekki er víst að tími vinnist til að svara öllum spurningum.

Persónulegar upplýsingar um spyrjendur eru eingöngu notaðar í starfsemi vefsins, til dæmis til að svör verði við hæfi spyrjenda. Spurningum er ekki sinnt ef spyrjandi villir á sér heimildir eða segir ekki nægileg deili á sér.

Spurningum sem eru ekki á verksviði vefsins er eytt.

Að öðru leyti er hægt að spyrja Vísindavefinn um allt milli himins og jarðar!

=

Hvernig geta stór mállíkön leyst verkefni sem þeim hefur ekki verið kennt sérstaklega að leysa?

Hafsteinn Einarsson

Upprunalega spurningin var eftirfarandi:
Hvernig lærir gervigreind að leysa verkefni sem henni hefur aldrei verið kennt nákvæmlega að leysa?

Stór mállíkön geta oft nýtt það sem þau lærðu við þjálfun til að leysa verkefni sem þau voru ekki sérstaklega þjálfuð fyrir. Þau geta líka notað leiðbeiningar og dæmi sem fylgja nýju verkefni. Að leysa nýtt verkefni merkir því yfirleitt að beita fyrri lærdómi við nýjar aðstæður. Það merkir ekki að líkanið hafi lært án gagna eða öðlast hæfni til að leysa hvaða verkefni sem er.

Spurningin vekur um leið aðra spurningu: hvernig fer fólk að því að leysa verkefni sem það hefur aldrei æft? Sú spurning er gömul og henni hefur ekki verið svarað með sannfærandi hætti. Hæfni manna til að setja kunnugleg atriði saman á nýjan hátt hefur verið deiluefni í hugfræði í áratugi, og lengi var því haldið fram að tauganet gætu ekki búið yfir henni.[1] Gervitauganet hafa þó einn kost umfram lifandi heila: hægt er að skoða hvert einasta tölugildi í þeim og gera tilraunir með þau beint. Rannsakendur sem reyna að skilja innviði mállíkana hafa sjálfir líkt viðfangsefninu við líffræði, þar sem einfalt þróunarferli getur af sér flókin kerfi sem þarf að rannsaka með nýjum verkfærum.[2]

Rétt er einnig að taka strax fram að spurningunni er ekki auðsvarað. Fræðin um stór mállíkön eru að miklu leyti tilraunadrifin: hvaða verkefni líkan ræður við kemur í ljós þegar það er prófað, og ekki er alltaf hægt að sjá það fyrir. Wei og samstarfsfólk tóku árið 2022 saman fjölda dæma um getu sem er ekki til staðar í minni líkönum en birtist í þeim stærri, án þess að hægt hafi verið að spá fyrir um hana með því að framlengja árangur minni líkana. Meðal dæmanna voru samlagning og frádráttur þriggja stafa talna, að finna orð út frá stöfum þess í rangri röð, að svara spurningum á persnesku og að ná árangri umfram ágiskun í fjölþættu þekkingarprófi með 57 greinum, allt frá stærðfræði til lögfræði.[3] Hér á eftir er lýst því sem vitað er um hvernig þessi hæfni verður til og hvar hún bregst.

Þjálfunin mótar hvernig líkanið vinnur

Tauganet er reiknikerfi með fjölda stillanlegra tölugilda, svokallaðra stika. Við þjálfun er útkoma líkansins borin saman við viðmið og stikunum breytt í smáum skrefum þannig að skekkjan minnki.[4] Stærðfræðinni að baki þessari þjálfun er lýst nánar í svari Vísindavefsins við spurningunni Hvaða stærðfræði liggur að baki gervigreind? Með nógu fjölbreyttum dæmum getur líkanið lært mynstur sem nýtast á ný gögn. Þessi hæfni kallast alhæfing: það sem lærðist af þjálfunardæmunum gagnast einnig þegar inntakið er annað.[5] Líkanið er þá ekki aðeins að herma eftir því sem það hefur séð. Séu þjálfunargögnin fá eða einhæf getur líkan hins vegar lært dæmin nánast utan að og staðið sig illa á nýjum gögnum. Það kallast ofmátun (e. overfitting) og lýsir sér í því að bilið milli skekkju á þjálfunargögnum og skekkju á nýjum gögnum verður of stórt.[6]

Af þessu leiðir að þróun gervigreindarlíkans líkist fremur ræktun en hefðbundinni forritun. Reglurnar sem líkanið fer eftir eru ekki skrifaðar fyrirfram eins og í hefðbundinni forritun, þar sem ljóst er hvað forritið gerir. Þær verða að hluta til í þjálfuninni og eru þeim sem þjálfa að hluta óþekktar. Sumar reglur eru þó tilgreindar í þjálfunargögnunum, en ekki er tryggt að líkanið fylgi þeim. Þessari samlíkingu, að líkön séu ræktuð fremur en smíðuð, er lýst ítarlega í bók Eliezers Yudkowsky og Nates Soares frá 2025, If Anyone Builds It, Everyone Dies.[7] Rannsakendur sem kortleggja innviði mállíkana lýsa því á sama hátt að einfaldar, mannsmíðaðar þjálfunaraðferðir geti af sér flókna innri virkni sem þarf að rannsaka eftir á.[8]
Þróun gervigreindarlíkans líkist fremur ræktun en hefðbundinni forritun. Reglurnar sem líkanið fer eftir eru ekki skrifaðar fyrirfram eins og í hefðbundinni forritun, þar sem ljóst er hvað forritið gerir. Þær verða að hluta til í þjálfuninni og eru þeim sem þjálfa að hluta óþekktar.
Þróun gervigreindarlíkans líkist fremur ræktun en hefðbundinni forritun. Reglurnar sem líkanið fer eftir eru ekki skrifaðar fyrirfram eins og í hefðbundinni forritun, þar sem ljóst er hvað forritið gerir. Þær verða að hluta til í þjálfuninni og eru þeim sem þjálfa að hluta óþekktar.

Í forþjálfun textamyndandi mállíkans er algengt verkefni að spá fyrir um næsta textabút út frá því sem kemur á undan. Textinn er brotinn niður í tóka (e. tokens), sem geta verið heil orð, orðhlutar eða tákn. Rétta svarið við hverju þjálfunardæmi er einfaldlega textinn sem kemur næst í þjálfunarefninu. Eigi líkanið til dæmis að spá fyrir um næsta orð á eftir „Reykjavík er höfuðborg“ er rétta svarið það orð sem stendur þar í raun í textanum, „Íslands“. Því þarf ekki manneskju til að semja sérstakt rétt svar fyrir hvert þjálfunardæmi og hægt er að þjálfa líkanið á nánast ótakmörkuðu magni af texta. Upplýsingar um rétt svar koma þannig úr gögnunum sjálfum (e. self-supervised learning).[9]

Þótt æfingin sé að spá fyrir um framhald þarf líkanið að nýta margs konar upplýsingar til að gera það vel. Málfræði, merkingartengsl og samhengi geta öll skipt máli. Í þjálfunartexta geta auk þess falist dæmi um útskýringar, þýðingar, rökræður og lausnir verkefna. Líkanið getur því lært af slíku efni án þess að hvert dæmi hafi verið merkt „nú kennum við þér að þýða“ eða „nú kennum við þér að draga saman texta“.[10]

Gagnlegt er að hugsa sér að líkanið læri leiðir til að vinna með upplýsingar, auk þess að læra einstök atriði úr gögnunum. Rannsóknir á innviðum stórra mállíkana benda til þess að hugtök séu sett fram á sama hátt inni í líkaninu óháð því í hvaða búningi þau birtast. Templeton og samstarfsfólk hjá Anthropic fundu árið 2024 í mállíkaninu Claude 3 Sonnet einingar sem bregðast við tilteknu hugtaki, til dæmis Golden Gate-brúnni í San Francisco, hvort sem brúin er nefnd á ensku eða öðrum tungumálum og jafnvel þegar hún birtist á mynd. Margar slíkar einingar reyndust fjöltyngdar og óháðar því hvort inntakið var texti eða mynd.[11] Þegar hugtak er sett fram á einn hátt innan líkansins nýtist það sem lærist um það í einu samhengi einnig í öðru. Það er ein ástæða þess að ekki þarf að byrja þjálfun frá grunni fyrir hvert nýtt verkefni.[12]

Leiðbeiningar geta virkjað fyrri lærdóm

Til að gera forþjálfað líkan að betri aðstoðarmanni er það oft þjálfað áfram á dæmum um fyrirmæli og æskileg svör. Einnig má nota mat fólks á því hvaða svör séu gagnlegri. Rannsókn Ouyang og samstarfsfólks á InstructGPT sýndi hvernig slík viðbótarþjálfun gat bætt fylgni við ætlun notanda. Þannig geta fyrirmælin „dragðu þetta saman í tveimur setningum“ kallað fram hæfni sem byggðist upp í fyrri þjálfun.[13]

Stundum duga fyrirmæli ein og sér. Í öðrum tilvikum hjálpar að sýna líkaninu nokkur dæmi. Í rannsókninni á GPT-3 voru mörg verkefni lögð fyrir með þessum hætti: líkanið fékk lýsingu á verkefninu og fáein dæmi um lausn þess í textanum og átti síðan að halda textanum áfram með lausn á næsta dæmi. Stikunum var ekki breytt fyrir neitt verkefnanna. Höfundarnir kölluðu þetta nám innan samhengis (e. in-context learning). Líkanið notar þá fyrirmælin og dæmin sem hluta af inntakinu þegar það reiknar út svarið. Enginn forritaði þessa hæfni inn í líkanið; hún kom fram við forþjálfunina og reyndist því sterkari sem líkönin voru stærri.[14]

Þörfin fyrir sýnidæmi á einkum við um eldri kynslóðir mállíkana. Þegar líkan er þjálfað áfram á fyrirmælum og svörum, eins og lýst var hér að ofan, batnar geta þess til að leysa ný verkefni út frá fyrirmælunum einum. Wei og samstarfsfólk sýndu árið 2022 að líkan sem hafði fengið slíka fyrirmælaþjálfun stóð sig betur án nokkurra dæma en GPT-3 gerði með dæmum í mörgum verkefnum.[15] Nútímaspjallmenni byggjast á slíkri þjálfun og þurfa því sjaldnast sýnidæmi til að skilja hvers er óskað.

Hvers vegna ætti æfing í að spá fyrir um næsta orð að skila slíkri hæfni? Ilya Sutskever, einn stofnenda OpenAI, hefur skýrt það með dæmi um glæpasögu. Á síðustu blaðsíðunni hefur spæjarinn safnað öllum saman og segir: „... og sá sem framdi glæpinn heitir“. Til að spá rétt fyrir um næsta orð duga hvorki málfræði né algeng orðasambönd. Sá sem spáir þarf að hafa fylgst með vísbendingunum í sögunni, haldið utan um persónurnar og dregið ályktanir af öllu saman. Líkan sem æfir sig í að spá fyrir um framhald á gríðarlegu magni fjölbreytts texta þarf því að byggja upp margs konar úrvinnslu til að standa sig vel.[16] Dæmið skýrir hugmyndina; hversu langt hæfnin nær í raun verður aðeins mælt með prófunum.

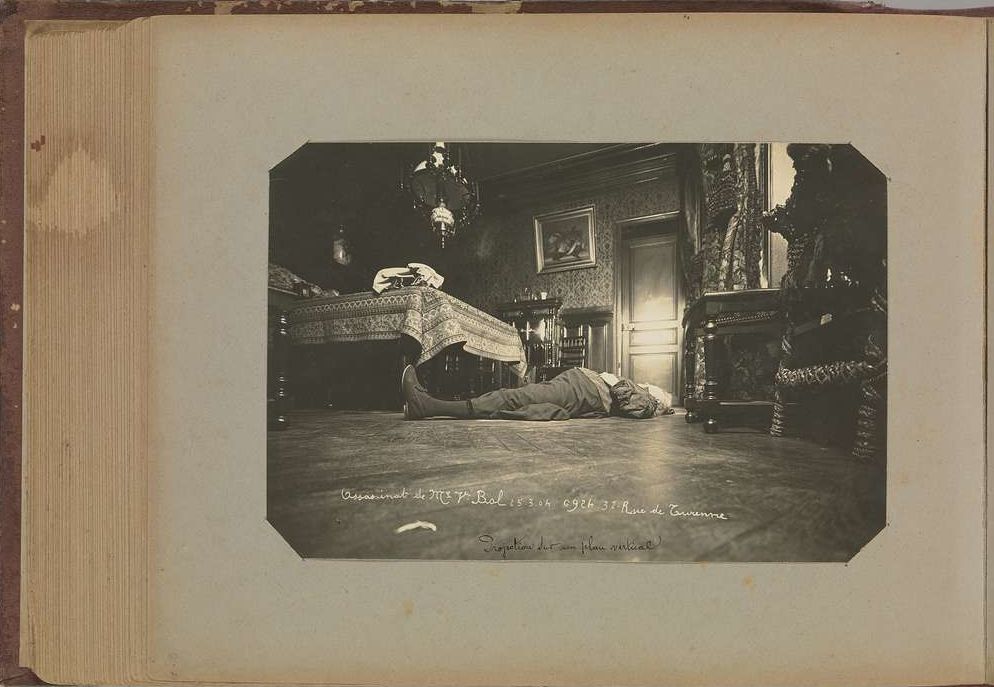
Hæfni sumra mállíkana til að spá fyrir um næsta orð hefur verið líkt við hæfnina til að benda á hinn seka við lok glæpasögu. Sá sem spáir rétt þarf að hafa fylgst með vísbendingunum í sögunni, haldið utan um persónurnar og dregið ályktanir af öllu saman.
Hæfni sumra mállíkana til að spá fyrir um næsta orð hefur verið líkt við hæfnina til að benda á hinn seka við lok glæpasögu. Sá sem spáir rétt þarf að hafa fylgst með vísbendingunum í sögunni, haldið utan um persónurnar og dregið ályktanir af öllu saman.

Skoðum einfalt, tilbúið dæmi. Við gefum líkaninu pörin „rauður → A“, „blár → A“ og „hestur → B“ og biðjum það að velja A eða B fyrir „hundur“. Líkan sem hefur lært merkingu orðanna getur ályktað að A tákni liti og B dýr og svarað B. Merkingarflokkarnir eru kunnuglegir, en það að kalla þá A og B er nýtt í þessu verkefni. Dæmin ákvarða þó ekki eina mögulega reglu; svarið byggist líka á því hvaða skýring samræmist fyrri lærdómi líkansins.[17]

Það er því munur á því að þjálfa líkan og því að það lagi svar sitt að nýjum upplýsingum. Þegar þjálfun er lokið breytist líkanið sjálft ekki meira. Stikarnir eru nákvæmlega þeir sömu í hverju samtali, hver sem notandinn er og hvað sem sagt er. Það sem breytist milli samtala er inntakið, og með því útreikningarnir sem gefa svarið. Líkanið getur þess vegna notað nýtt heiti eða nýjar forsendur innan samtals, en það lærir ekkert varanlega af því. Að vista samtal og nota það síðar í nýrri þjálfun er annað ferli, sem býr til nýja útgáfu af líkaninu.[18]

Ný samsetning getur orðið að nýrri lausn

Verkefni getur líka verið nýtt vegna þess að kunnuglegir hlutir eru settir saman á nýjan hátt. Skýrt dæmi er yfirfærsla milli tungumála (e. cross-lingual transfer). Pires og samstarfsfólk hjá Google sýndu árið 2019 að fjöltyngt BERT-líkan, forþjálfað á texta á 104 tungumálum, mátti þjálfa til að leysa tiltekið verkefni með merktum dæmum á einu tungumáli, og að það leysti þá sama verkefni á öðrum tungumálum án þess að hafa fengið eitt einasta dæmi um það á þeim málum.[19] Líkanið hafði lært að leysa verkefnið á ensku og að skilja hin tungumálin í forþjálfuninni sem gerði því kleift að tengja þetta tvennt saman. Þegar það leysti verkefnið á nýju tungumáli gat það nýtt færni sína á öðru tungumáli þó það hefði aldrei séð þá saman í þjálfun á tungumáli fyrirspurnarinnar. Slík samsetning er þó ekki sjálfgefin. Hún þarf að lærast og hana þarf að prófa.

Lake og Baroni sýndu árið 2023 að hægt væri að þjálfa tauganet á mörgum litlum verkefnum þannig að það lærði að túlka ný orð og sameina þau samkvæmt reglum út frá fáum dæmum. Þetta er dæmi um að læra að læra. Rannsóknin sýndi slíka alhæfingu í afmörkuðu tilraunaumhverfi; hún sýndi þó ekki að venjulegt spjalllíkan gæti tileinkað sér hvaða nýja reglukerfi sem er.[20]

Takmörkin sjást meðal annars þegar nýtt verkefni krefst annars konar samsetninga en líkanið hefur æft. Þá getur velgengni í kunnuglegum verkefnum gefið of bjartsýna mynd af hæfninni. Lake og Baroni lýsa einmitt því að líkanið þeirra ráði ekki sjálfkrafa við alhæfingu utan þess sviðs sem það var þjálfað á.[21]

Mállíkön leysa þó ekki öll ný verkefni, jafnvel þótt þau virðist einföld. Þekkt dæmi er spurningin: „Ég ætla að þvo bílinn minn. Bílaþvottastöðin er í 50 metra fjarlægð. Á ég að ganga eða keyra?“ Flestum finnst svarið augljóst: bíllinn þarf að komast á þvottastöðina, svo það þarf að keyra. Þegar fyrirtækið Opper lagði spurninguna fyrir 53 mállíkön í febrúar 2026 svöruðu 42 þeirra að best væri að ganga, með þeim rökum að 50 metrar væru stutt vegalengd.[22] Li og samstarfsfólk könnuðu þetta nánar árið 2026 með 500 sambærilegum spurningum. Þar kom fram að áberandi yfirborðsvísbending, hér vegalengdin, hefur margfalt meiri áhrif á svarið en markmiðið sjálft, og ekkert þeirra 14 líkana sem prófuð voru svaraði rétt í meira en 75% tilvika þegar krafist var að svarið væri rétt í öllum tíu endurtekningum.[23] Þess ber að geta að líkönin breytast hratt og niðurstöður af þessu tagi geta úrelst á fáum mánuðum.

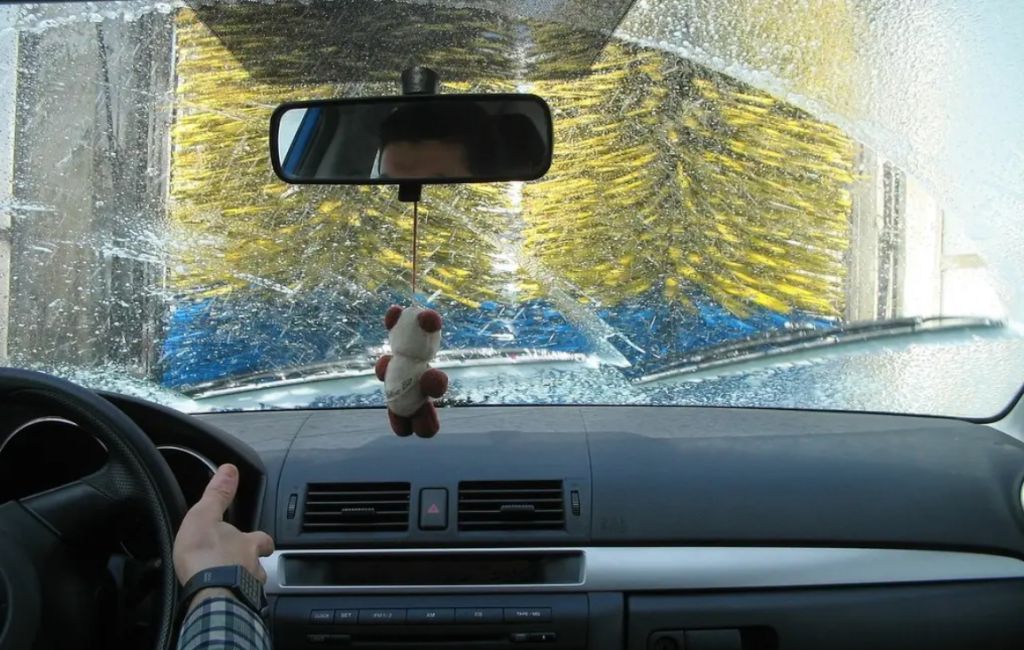
„Ég ætla að þvo bílinn minn. Bílaþvottastöðin er í 50 metra fjarlægð. Á ég að ganga eða keyra?“

„Ég ætla að þvo bílinn minn. Bílaþvottastöðin er í 50 metra fjarlægð. Á ég að ganga eða keyra?“

Dell’Acqua, Mollick og samstarfsfólk hafa kallað þetta úfin mörk tækninnar (e. jagged technological frontier): sum verkefni leysa líkönin auðveldlega, en önnur, sem virðast álíka erfið, eru utan getu þeirra. Í tilraun þeirra með 758 ráðgjafa hjá Boston Consulting Group árið 2023 luku þátttakendur sem notuðu GPT-4 fleiri verkefnum, voru fljótari og skiluðu betri lausnum í verkefnum innan markanna. Í verkefni sem valið var utan markanna voru þeir hins vegar 19 prósentustigum ólíklegri til að komast að réttri niðurstöðu en þeir sem unnu án gervigreindar.[24] Það er því ekki hægt að ganga út frá því að líkan sem leysir erfitt verkefni ráði líka við annað sem virðist auðveldara. Hvort tiltekið verkefni er innan markanna þarf að prófa.

Loks þarf að greina á milli þess að verkefni sé nýtt fyrir notandann og að líkanið hafi aldrei séð neitt sambærilegt. Þjálfunarsöfn geta innihaldið svipaðar spurningar eða jafnvel gögn úr prófunum. Höfundar GPT-3-greinarinnar könnuðu slíka skörun sérstaklega. Til að sýna fram á alhæfingu þarf því vandaðar prófanir á nýjum dæmum og nýjum samsetningum, ekki aðeins eitt sannfærandi svar.[25]

Styrkingarnám færir mörkin

Allt sem lýst er hér að framan byggist á texta sem fólk skrifaði. Líkanið lærir af honum í forþjálfun og af fyrirmælum og svörum fólks í viðbótarþjálfun, og hæfni þeirra sem skrifuðu setur þeim lærdómi eðlileg mörk. Með styrkingarnámi (e. reinforcement learning) er þessu breytt. Þá fær líkanið verkefni þar sem hægt er að sannreyna lausnina, til dæmis stærðfræðidæmi eða forritunarverkefni, reynir við þau aftur og aftur og er verðlaunað fyrir réttar lausnir, án þess að nokkur sýni því hvernig á að leysa þau. Þekktasta dæmið utan tungumáls er AlphaGo Zero frá 2017. Það lærði borðspilið Go eingöngu með því að tefla við sjálft sig, án nokkurra mannlegra leikja, og vann fyrri útgáfuna, sem hafði lært af leikjum manna, með 100 vinningum gegn engum.[26]

Sama hugmynd hefur verið færð yfir á mállíkön. Svokölluð rökleiðslulíkön OpenAI, o1-línan frá 2024, eru þjálfuð með umfangsmiklu styrkingarnámi til að „rökhugsa“ skref fyrir skref áður en þau svara.[27] Höfundar DeepSeek-R1 sýndu árið 2025 að slík rökfærsla getur komið fram með styrkingarnámi einu saman, án þess að fólk skrifi rökfærslurnar fyrir líkanið, og bentu á að mannleg rökfærslumynstur gætu jafnvel takmarkað hvað líkanið lærir.[28] Nýjasta dæmið er umdeilt. Hinn 8. september 2026 tilkynnti OpenAI að kerfi um tíu þúsund samvirkra gervigreindarfulltrúa, knúið óútgefnu líkani fyrirtækisins, hefði sett fram sönnun þess að lausnir Navier–Stokes-jafnanna, sem lýsa hreyfingu vökva, geti orðið sérstæðar á endanlegum tíma, en það er eitt af árþúsundavandamálum Clay-stærðfræðistofnunarinnar. Sönnuninni fylgdi formgerð útgáfa í sönnunarforritinu Lean, og fyrirtækið kvaðst ekki ætla að sækjast eftir verðlaununum.[29] Stærðfræðingar hafa gagnrýnt bæði hvernig staðið var að verki og hver á heiðurinn skilið, og þegar þetta er skrifað hefur stærðfræðisamfélagið ekki lagt óháð mat á sönnunina.[30] Hvort sem sú sönnun stenst eða ekki sýna dæmin um AlphaGo Zero og DeepSeek-R1 að þegar líkan getur sjálft fengið að vita hvort lausn er rétt er geta þeirra sem skrifuðu þjálfunartextann ekki lengur efri mörk þess sem það getur lært.

Hæfnin verður þannig til í samspili umfangsmikillar þjálfunar og upplýsinganna sem fylgja verkefninu. Ný lausn getur byggst á gömlum lærdómi, jafnvel þótt enginn hafi skrifað nákvæma uppskrift að þeirri lausn inn í forritið. Hvar mörk þessarar hæfni liggja verður hins vegar ekki leitt út fyrir fram. Því er svarað með tilraunum, og svarið breytist eftir því sem líkönin þróast.

Tilvísanir:
  1. ^ Lake, B. M. og Baroni, M. (2023). Human-like systematic generalization through a meta-learning neural network. Nature, 623, 115–121. https://doi.org/10.1038/s41586-023-06668-3
  2. ^ Lindsey, J. o.fl. (2025, 27. mars). On the Biology of a Large Language Model. Transformer Circuits Thread, Anthropic. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
  3. ^ Wei, J. o.fl. (2022). Emergent Abilities of Large Language Models. Transactions on Machine Learning Research. https://arxiv.org/abs/2206.07682
  4. ^ LeCun, Y., Bengio, Y. og Hinton, G. (2015). Deep learning. Nature, 521, 436–444. https://doi.org/10.1038/nature14539
  5. ^ LeCun, Y. o.fl. (2015).
  6. ^ Goodfellow, I., Bengio, Y. og Courville, A. (2016). Deep Learning. MIT Press. Kafli 5.2, „Capacity, Overfitting and Underfitting“. https://www.deeplearningbook.org/
  7. ^ Yudkowsky, E. og Soares, N. (2025). If Anyone Builds It, Everyone Dies: Why Superhuman AI Would Kill Us All. Little, Brown and Company. https://ifanyonebuildsit.com/
  8. ^ Lindsey, J. o.fl. (2025).
  9. ^ Radford, A., Wu, J., Child, R., Luan, D., Amodei, D. og Sutskever, I. (2019). Language Models are Unsupervised Multitask Learners. Rannsóknarskýrsla, OpenAI. https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
  10. ^ Radford, A. o.fl. (2019).
  11. ^ Templeton, A. o.fl. (2024, 21. maí). Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet. Transformer Circuits Thread, Anthropic. https://transformer-circuits.pub/2024/scaling-monosemanticity/index.html
  12. ^ LeCun, Y. o.fl. (2015).
  13. ^ Ouyang, L. o.fl. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35, 27730–27744. arXiv:2203.02155
  14. ^ Brown, T. B. o.fl. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems, 33, 1877–1901. arXiv:2005.14165
  15. ^ Wei, J. o.fl. (2022). Finetuned Language Models Are Zero-Shot Learners. International Conference on Learning Representations (ICLR 2022). arXiv:2109.01652
  16. ^ Sutskever, I. og Huang, J. (2023, mars). Fireside Chat with Ilya Sutskever and Jensen Huang: AI Today and Vision of the Future. Upptaka af samtali á ráðstefnunni NVIDIA GTC 2023, fyrirlestur S52092. https://www.nvidia.com/en-us/on-demand/session/gtcspring23-s52092/
  17. ^ Garg, S., Tsipras, D., Liang, P. og Valiant, G. (2022). What Can Transformers Learn In-Context? A Case Study of Simple Function Classes. Advances in Neural Information Processing Systems, 35. arXiv:2208.01066
  18. ^ Garg, S. o.fl. (2022).
  19. ^ Pires, T., Schlinger, E. og Garrette, D. (2019). How Multilingual is Multilingual BERT? Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, 4996–5001. arXiv:2208.01066
  20. ^ Lake og Baroni (2023).
  21. ^ Lake og Baroni (2023).
  22. ^ Wunderlich, F. (2026, 19. febrúar). Car Wash Test on 53 leading AI models: “I want to wash my car. The car wash is 50 meters away. Should I walk or drive?” Opper, bloggfærsla. https://opper.ai/blog/car-wash-test
  23. ^ Li, Y., Zhang, L., Jiang, T., Krishnan, R. og Padman, R. (2026). The Model Says Walk: How Surface Heuristics Override Implicit Constraints in LLM Reasoning. Forprentun, arXiv:2603.29025. arXiv:2603.29025
  24. ^ Dell’Acqua, F., McFowland III, E., Mollick, E., Lifshitz-Assaf, H., Kellogg, K. C., Rajendran, S., Krayer, L., Candelon, F. og Lakhani, K. R. (2023). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of AI on Knowledge Worker Productivity and Quality. Harvard Business School Working Paper 24-013. http://dx.doi.org/10.2139/ssrn.4573321
  25. ^ Brown, T. B. o.fl. (2020).
  26. ^ Silver, D. o.fl. (2017). Mastering the game of Go without human knowledge. Nature, 550, 354–359. https://doi.org/10.1038/nature24270
  27. ^ OpenAI (2024). OpenAI o1 System Card. arXiv:2412.16720
  28. ^ Guo, D. o.fl. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645, 633–638. https://doi.org/10.1038/s41586-025-09422-z
  29. ^ OpenAI (2026, 8. september). On the Navier–Stokes Millennium Prize Problem. Tilkynning. https://openai.com/index/navier-stokes-solution/
  30. ^ Kahn, J. (2026, 8. september). OpenAI says it cracked one of math’s grand challenges. But there are troubling questions about how they did it—and what it means for us all. Fortune. https://fortune.com/2026/09/08/openai-says-it-cracked-navier-stokes-math-grand-challenge-buckmaster-accusation-cheating-intimidation-tao-lament/

Myndir:

Höfundur

Hafsteinn Einarsson

dósent í tölvunarfræði við HÍ

Útgáfudagur

28.9.2026

Spyrjandi

Arnar Elvarsson

Tilvísun

Hafsteinn Einarsson. „Hvernig geta stór mállíkön leyst verkefni sem þeim hefur ekki verið kennt sérstaklega að leysa?“ Vísindavefurinn, 28. september 2026, sótt 28. september 2026, https://visindavefur.is/svar.php?id=89681.

Hafsteinn Einarsson. (2026, 28. september). Hvernig geta stór mállíkön leyst verkefni sem þeim hefur ekki verið kennt sérstaklega að leysa? Vísindavefurinn. https://visindavefur.is/svar.php?id=89681

Hafsteinn Einarsson. „Hvernig geta stór mállíkön leyst verkefni sem þeim hefur ekki verið kennt sérstaklega að leysa?“ Vísindavefurinn. 28. sep. 2026. Vefsíða. 28. sep. 2026. <https://visindavefur.is/svar.php?id=89681>.

Chicago | APA | MLA

Senda grein til vinar

=

Hvernig geta stór mállíkön leyst verkefni sem þeim hefur ekki verið kennt sérstaklega að leysa?
Upprunalega spurningin var eftirfarandi:

Hvernig lærir gervigreind að leysa verkefni sem henni hefur aldrei verið kennt nákvæmlega að leysa?

Stór mállíkön geta oft nýtt það sem þau lærðu við þjálfun til að leysa verkefni sem þau voru ekki sérstaklega þjálfuð fyrir. Þau geta líka notað leiðbeiningar og dæmi sem fylgja nýju verkefni. Að leysa nýtt verkefni merkir því yfirleitt að beita fyrri lærdómi við nýjar aðstæður. Það merkir ekki að líkanið hafi lært án gagna eða öðlast hæfni til að leysa hvaða verkefni sem er.

Spurningin vekur um leið aðra spurningu: hvernig fer fólk að því að leysa verkefni sem það hefur aldrei æft? Sú spurning er gömul og henni hefur ekki verið svarað með sannfærandi hætti. Hæfni manna til að setja kunnugleg atriði saman á nýjan hátt hefur verið deiluefni í hugfræði í áratugi, og lengi var því haldið fram að tauganet gætu ekki búið yfir henni.[1] Gervitauganet hafa þó einn kost umfram lifandi heila: hægt er að skoða hvert einasta tölugildi í þeim og gera tilraunir með þau beint. Rannsakendur sem reyna að skilja innviði mállíkana hafa sjálfir líkt viðfangsefninu við líffræði, þar sem einfalt þróunarferli getur af sér flókin kerfi sem þarf að rannsaka með nýjum verkfærum.[2]

Rétt er einnig að taka strax fram að spurningunni er ekki auðsvarað. Fræðin um stór mállíkön eru að miklu leyti tilraunadrifin: hvaða verkefni líkan ræður við kemur í ljós þegar það er prófað, og ekki er alltaf hægt að sjá það fyrir. Wei og samstarfsfólk tóku árið 2022 saman fjölda dæma um getu sem er ekki til staðar í minni líkönum en birtist í þeim stærri, án þess að hægt hafi verið að spá fyrir um hana með því að framlengja árangur minni líkana. Meðal dæmanna voru samlagning og frádráttur þriggja stafa talna, að finna orð út frá stöfum þess í rangri röð, að svara spurningum á persnesku og að ná árangri umfram ágiskun í fjölþættu þekkingarprófi með 57 greinum, allt frá stærðfræði til lögfræði.[3] Hér á eftir er lýst því sem vitað er um hvernig þessi hæfni verður til og hvar hún bregst.

Þjálfunin mótar hvernig líkanið vinnur

Tauganet er reiknikerfi með fjölda stillanlegra tölugilda, svokallaðra stika. Við þjálfun er útkoma líkansins borin saman við viðmið og stikunum breytt í smáum skrefum þannig að skekkjan minnki.[4] Stærðfræðinni að baki þessari þjálfun er lýst nánar í svari Vísindavefsins við spurningunni Hvaða stærðfræði liggur að baki gervigreind? Með nógu fjölbreyttum dæmum getur líkanið lært mynstur sem nýtast á ný gögn. Þessi hæfni kallast alhæfing: það sem lærðist af þjálfunardæmunum gagnast einnig þegar inntakið er annað.[5] Líkanið er þá ekki aðeins að herma eftir því sem það hefur séð. Séu þjálfunargögnin fá eða einhæf getur líkan hins vegar lært dæmin nánast utan að og staðið sig illa á nýjum gögnum. Það kallast ofmátun (e. overfitting) og lýsir sér í því að bilið milli skekkju á þjálfunargögnum og skekkju á nýjum gögnum verður of stórt.[6]

Af þessu leiðir að þróun gervigreindarlíkans líkist fremur ræktun en hefðbundinni forritun. Reglurnar sem líkanið fer eftir eru ekki skrifaðar fyrirfram eins og í hefðbundinni forritun, þar sem ljóst er hvað forritið gerir. Þær verða að hluta til í þjálfuninni og eru þeim sem þjálfa að hluta óþekktar. Sumar reglur eru þó tilgreindar í þjálfunargögnunum, en ekki er tryggt að líkanið fylgi þeim. Þessari samlíkingu, að líkön séu ræktuð fremur en smíðuð, er lýst ítarlega í bók Eliezers Yudkowsky og Nates Soares frá 2025, If Anyone Builds It, Everyone Dies.[7] Rannsakendur sem kortleggja innviði mállíkana lýsa því á sama hátt að einfaldar, mannsmíðaðar þjálfunaraðferðir geti af sér flókna innri virkni sem þarf að rannsaka eftir á.[8]

Þróun gervigreindarlíkans líkist fremur ræktun en hefðbundinni forritun. Reglurnar sem líkanið fer eftir eru ekki skrifaðar fyrirfram eins og í hefðbundinni forritun, þar sem ljóst er hvað forritið gerir. Þær verða að hluta til í þjálfuninni og eru þeim sem þjálfa að hluta óþekktar.

Þróun gervigreindarlíkans líkist fremur ræktun en hefðbundinni forritun. Reglurnar sem líkanið fer eftir eru ekki skrifaðar fyrirfram eins og í hefðbundinni forritun, þar sem ljóst er hvað forritið gerir. Þær verða að hluta til í þjálfuninni og eru þeim sem þjálfa að hluta óþekktar.

Í forþjálfun textamyndandi mállíkans er algengt verkefni að spá fyrir um næsta textabút út frá því sem kemur á undan. Textinn er brotinn niður í tóka (e. tokens), sem geta verið heil orð, orðhlutar eða tákn. Rétta svarið við hverju þjálfunardæmi er einfaldlega textinn sem kemur næst í þjálfunarefninu. Eigi líkanið til dæmis að spá fyrir um næsta orð á eftir „Reykjavík er höfuðborg“ er rétta svarið það orð sem stendur þar í raun í textanum, „Íslands“. Því þarf ekki manneskju til að semja sérstakt rétt svar fyrir hvert þjálfunardæmi og hægt er að þjálfa líkanið á nánast ótakmörkuðu magni af texta. Upplýsingar um rétt svar koma þannig úr gögnunum sjálfum (e. self-supervised learning).[9]

Þótt æfingin sé að spá fyrir um framhald þarf líkanið að nýta margs konar upplýsingar til að gera það vel. Málfræði, merkingartengsl og samhengi geta öll skipt máli. Í þjálfunartexta geta auk þess falist dæmi um útskýringar, þýðingar, rökræður og lausnir verkefna. Líkanið getur því lært af slíku efni án þess að hvert dæmi hafi verið merkt „nú kennum við þér að þýða“ eða „nú kennum við þér að draga saman texta“.[10]

Gagnlegt er að hugsa sér að líkanið læri leiðir til að vinna með upplýsingar, auk þess að læra einstök atriði úr gögnunum. Rannsóknir á innviðum stórra mállíkana benda til þess að hugtök séu sett fram á sama hátt inni í líkaninu óháð því í hvaða búningi þau birtast. Templeton og samstarfsfólk hjá Anthropic fundu árið 2024 í mállíkaninu Claude 3 Sonnet einingar sem bregðast við tilteknu hugtaki, til dæmis Golden Gate-brúnni í San Francisco, hvort sem brúin er nefnd á ensku eða öðrum tungumálum og jafnvel þegar hún birtist á mynd. Margar slíkar einingar reyndust fjöltyngdar og óháðar því hvort inntakið var texti eða mynd.[11] Þegar hugtak er sett fram á einn hátt innan líkansins nýtist það sem lærist um það í einu samhengi einnig í öðru. Það er ein ástæða þess að ekki þarf að byrja þjálfun frá grunni fyrir hvert nýtt verkefni.[12]

Leiðbeiningar geta virkjað fyrri lærdóm

Til að gera forþjálfað líkan að betri aðstoðarmanni er það oft þjálfað áfram á dæmum um fyrirmæli og æskileg svör. Einnig má nota mat fólks á því hvaða svör séu gagnlegri. Rannsókn Ouyang og samstarfsfólks á InstructGPT sýndi hvernig slík viðbótarþjálfun gat bætt fylgni við ætlun notanda. Þannig geta fyrirmælin „dragðu þetta saman í tveimur setningum“ kallað fram hæfni sem byggðist upp í fyrri þjálfun.[13]

Stundum duga fyrirmæli ein og sér. Í öðrum tilvikum hjálpar að sýna líkaninu nokkur dæmi. Í rannsókninni á GPT-3 voru mörg verkefni lögð fyrir með þessum hætti: líkanið fékk lýsingu á verkefninu og fáein dæmi um lausn þess í textanum og átti síðan að halda textanum áfram með lausn á næsta dæmi. Stikunum var ekki breytt fyrir neitt verkefnanna. Höfundarnir kölluðu þetta nám innan samhengis (e. in-context learning). Líkanið notar þá fyrirmælin og dæmin sem hluta af inntakinu þegar það reiknar út svarið. Enginn forritaði þessa hæfni inn í líkanið; hún kom fram við forþjálfunina og reyndist því sterkari sem líkönin voru stærri.[14]

Þörfin fyrir sýnidæmi á einkum við um eldri kynslóðir mállíkana. Þegar líkan er þjálfað áfram á fyrirmælum og svörum, eins og lýst var hér að ofan, batnar geta þess til að leysa ný verkefni út frá fyrirmælunum einum. Wei og samstarfsfólk sýndu árið 2022 að líkan sem hafði fengið slíka fyrirmælaþjálfun stóð sig betur án nokkurra dæma en GPT-3 gerði með dæmum í mörgum verkefnum.[15] Nútímaspjallmenni byggjast á slíkri þjálfun og þurfa því sjaldnast sýnidæmi til að skilja hvers er óskað.

Hvers vegna ætti æfing í að spá fyrir um næsta orð að skila slíkri hæfni? Ilya Sutskever, einn stofnenda OpenAI, hefur skýrt það með dæmi um glæpasögu. Á síðustu blaðsíðunni hefur spæjarinn safnað öllum saman og segir: „... og sá sem framdi glæpinn heitir“. Til að spá rétt fyrir um næsta orð duga hvorki málfræði né algeng orðasambönd. Sá sem spáir þarf að hafa fylgst með vísbendingunum í sögunni, haldið utan um persónurnar og dregið ályktanir af öllu saman. Líkan sem æfir sig í að spá fyrir um framhald á gríðarlegu magni fjölbreytts texta þarf því að byggja upp margs konar úrvinnslu til að standa sig vel.[16] Dæmið skýrir hugmyndina; hversu langt hæfnin nær í raun verður aðeins mælt með prófunum.

Hæfni sumra mállíkana til að spá fyrir um næsta orð hefur verið líkt við hæfnina til að benda á hinn seka við lok glæpasögu. Sá sem spáir rétt þarf að hafa fylgst með vísbendingunum í sögunni, haldið utan um persónurnar og dregið ályktanir af öllu saman.

Hæfni sumra mállíkana til að spá fyrir um næsta orð hefur verið líkt við hæfnina til að benda á hinn seka við lok glæpasögu. Sá sem spáir rétt þarf að hafa fylgst með vísbendingunum í sögunni, haldið utan um persónurnar og dregið ályktanir af öllu saman.

Skoðum einfalt, tilbúið dæmi. Við gefum líkaninu pörin „rauður → A“, „blár → A“ og „hestur → B“ og biðjum það að velja A eða B fyrir „hundur“. Líkan sem hefur lært merkingu orðanna getur ályktað að A tákni liti og B dýr og svarað B. Merkingarflokkarnir eru kunnuglegir, en það að kalla þá A og B er nýtt í þessu verkefni. Dæmin ákvarða þó ekki eina mögulega reglu; svarið byggist líka á því hvaða skýring samræmist fyrri lærdómi líkansins.[17]

Það er því munur á því að þjálfa líkan og því að það lagi svar sitt að nýjum upplýsingum. Þegar þjálfun er lokið breytist líkanið sjálft ekki meira. Stikarnir eru nákvæmlega þeir sömu í hverju samtali, hver sem notandinn er og hvað sem sagt er. Það sem breytist milli samtala er inntakið, og með því útreikningarnir sem gefa svarið. Líkanið getur þess vegna notað nýtt heiti eða nýjar forsendur innan samtals, en það lærir ekkert varanlega af því. Að vista samtal og nota það síðar í nýrri þjálfun er annað ferli, sem býr til nýja útgáfu af líkaninu.[18]

Ný samsetning getur orðið að nýrri lausn

Verkefni getur líka verið nýtt vegna þess að kunnuglegir hlutir eru settir saman á nýjan hátt. Skýrt dæmi er yfirfærsla milli tungumála (e. cross-lingual transfer). Pires og samstarfsfólk hjá Google sýndu árið 2019 að fjöltyngt BERT-líkan, forþjálfað á texta á 104 tungumálum, mátti þjálfa til að leysa tiltekið verkefni með merktum dæmum á einu tungumáli, og að það leysti þá sama verkefni á öðrum tungumálum án þess að hafa fengið eitt einasta dæmi um það á þeim málum.[19] Líkanið hafði lært að leysa verkefnið á ensku og að skilja hin tungumálin í forþjálfuninni sem gerði því kleift að tengja þetta tvennt saman. Þegar það leysti verkefnið á nýju tungumáli gat það nýtt færni sína á öðru tungumáli þó það hefði aldrei séð þá saman í þjálfun á tungumáli fyrirspurnarinnar. Slík samsetning er þó ekki sjálfgefin. Hún þarf að lærast og hana þarf að prófa.

Lake og Baroni sýndu árið 2023 að hægt væri að þjálfa tauganet á mörgum litlum verkefnum þannig að það lærði að túlka ný orð og sameina þau samkvæmt reglum út frá fáum dæmum. Þetta er dæmi um að læra að læra. Rannsóknin sýndi slíka alhæfingu í afmörkuðu tilraunaumhverfi; hún sýndi þó ekki að venjulegt spjalllíkan gæti tileinkað sér hvaða nýja reglukerfi sem er.[20]

Takmörkin sjást meðal annars þegar nýtt verkefni krefst annars konar samsetninga en líkanið hefur æft. Þá getur velgengni í kunnuglegum verkefnum gefið of bjartsýna mynd af hæfninni. Lake og Baroni lýsa einmitt því að líkanið þeirra ráði ekki sjálfkrafa við alhæfingu utan þess sviðs sem það var þjálfað á.[21]

Mállíkön leysa þó ekki öll ný verkefni, jafnvel þótt þau virðist einföld. Þekkt dæmi er spurningin: „Ég ætla að þvo bílinn minn. Bílaþvottastöðin er í 50 metra fjarlægð. Á ég að ganga eða keyra?“ Flestum finnst svarið augljóst: bíllinn þarf að komast á þvottastöðina, svo það þarf að keyra. Þegar fyrirtækið Opper lagði spurninguna fyrir 53 mállíkön í febrúar 2026 svöruðu 42 þeirra að best væri að ganga, með þeim rökum að 50 metrar væru stutt vegalengd.[22] Li og samstarfsfólk könnuðu þetta nánar árið 2026 með 500 sambærilegum spurningum. Þar kom fram að áberandi yfirborðsvísbending, hér vegalengdin, hefur margfalt meiri áhrif á svarið en markmiðið sjálft, og ekkert þeirra 14 líkana sem prófuð voru svaraði rétt í meira en 75% tilvika þegar krafist var að svarið væri rétt í öllum tíu endurtekningum.[23] Þess ber að geta að líkönin breytast hratt og niðurstöður af þessu tagi geta úrelst á fáum mánuðum.

„Ég ætla að þvo bílinn minn. Bílaþvottastöðin er í 50 metra fjarlægð. Á ég að ganga eða keyra?“

„Ég ætla að þvo bílinn minn. Bílaþvottastöðin er í 50 metra fjarlægð. Á ég að ganga eða keyra?“

Dell’Acqua, Mollick og samstarfsfólk hafa kallað þetta úfin mörk tækninnar (e. jagged technological frontier): sum verkefni leysa líkönin auðveldlega, en önnur, sem virðast álíka erfið, eru utan getu þeirra. Í tilraun þeirra með 758 ráðgjafa hjá Boston Consulting Group árið 2023 luku þátttakendur sem notuðu GPT-4 fleiri verkefnum, voru fljótari og skiluðu betri lausnum í verkefnum innan markanna. Í verkefni sem valið var utan markanna voru þeir hins vegar 19 prósentustigum ólíklegri til að komast að réttri niðurstöðu en þeir sem unnu án gervigreindar.[24] Það er því ekki hægt að ganga út frá því að líkan sem leysir erfitt verkefni ráði líka við annað sem virðist auðveldara. Hvort tiltekið verkefni er innan markanna þarf að prófa.

Loks þarf að greina á milli þess að verkefni sé nýtt fyrir notandann og að líkanið hafi aldrei séð neitt sambærilegt. Þjálfunarsöfn geta innihaldið svipaðar spurningar eða jafnvel gögn úr prófunum. Höfundar GPT-3-greinarinnar könnuðu slíka skörun sérstaklega. Til að sýna fram á alhæfingu þarf því vandaðar prófanir á nýjum dæmum og nýjum samsetningum, ekki aðeins eitt sannfærandi svar.[25]

Styrkingarnám færir mörkin

Allt sem lýst er hér að framan byggist á texta sem fólk skrifaði. Líkanið lærir af honum í forþjálfun og af fyrirmælum og svörum fólks í viðbótarþjálfun, og hæfni þeirra sem skrifuðu setur þeim lærdómi eðlileg mörk. Með styrkingarnámi (e. reinforcement learning) er þessu breytt. Þá fær líkanið verkefni þar sem hægt er að sannreyna lausnina, til dæmis stærðfræðidæmi eða forritunarverkefni, reynir við þau aftur og aftur og er verðlaunað fyrir réttar lausnir, án þess að nokkur sýni því hvernig á að leysa þau. Þekktasta dæmið utan tungumáls er AlphaGo Zero frá 2017. Það lærði borðspilið Go eingöngu með því að tefla við sjálft sig, án nokkurra mannlegra leikja, og vann fyrri útgáfuna, sem hafði lært af leikjum manna, með 100 vinningum gegn engum.[26]

Sama hugmynd hefur verið færð yfir á mállíkön. Svokölluð rökleiðslulíkön OpenAI, o1-línan frá 2024, eru þjálfuð með umfangsmiklu styrkingarnámi til að „rökhugsa“ skref fyrir skref áður en þau svara.[27] Höfundar DeepSeek-R1 sýndu árið 2025 að slík rökfærsla getur komið fram með styrkingarnámi einu saman, án þess að fólk skrifi rökfærslurnar fyrir líkanið, og bentu á að mannleg rökfærslumynstur gætu jafnvel takmarkað hvað líkanið lærir.[28] Nýjasta dæmið er umdeilt. Hinn 8. september 2026 tilkynnti OpenAI að kerfi um tíu þúsund samvirkra gervigreindarfulltrúa, knúið óútgefnu líkani fyrirtækisins, hefði sett fram sönnun þess að lausnir Navier–Stokes-jafnanna, sem lýsa hreyfingu vökva, geti orðið sérstæðar á endanlegum tíma, en það er eitt af árþúsundavandamálum Clay-stærðfræðistofnunarinnar. Sönnuninni fylgdi formgerð útgáfa í sönnunarforritinu Lean, og fyrirtækið kvaðst ekki ætla að sækjast eftir verðlaununum.[29] Stærðfræðingar hafa gagnrýnt bæði hvernig staðið var að verki og hver á heiðurinn skilið, og þegar þetta er skrifað hefur stærðfræðisamfélagið ekki lagt óháð mat á sönnunina.[30] Hvort sem sú sönnun stenst eða ekki sýna dæmin um AlphaGo Zero og DeepSeek-R1 að þegar líkan getur sjálft fengið að vita hvort lausn er rétt er geta þeirra sem skrifuðu þjálfunartextann ekki lengur efri mörk þess sem það getur lært.

Hæfnin verður þannig til í samspili umfangsmikillar þjálfunar og upplýsinganna sem fylgja verkefninu. Ný lausn getur byggst á gömlum lærdómi, jafnvel þótt enginn hafi skrifað nákvæma uppskrift að þeirri lausn inn í forritið. Hvar mörk þessarar hæfni liggja verður hins vegar ekki leitt út fyrir fram. Því er svarað með tilraunum, og svarið breytist eftir því sem líkönin þróast.

Tilvísanir:
  1. ^ Lake, B. M. og Baroni, M. (2023). Human-like systematic generalization through a meta-learning neural network. Nature, 623, 115–121. https://doi.org/10.1038/s41586-023-06668-3
  2. ^ Lindsey, J. o.fl. (2025, 27. mars). On the Biology of a Large Language Model. Transformer Circuits Thread, Anthropic. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
  3. ^ Wei, J. o.fl. (2022). Emergent Abilities of Large Language Models. Transactions on Machine Learning Research. https://arxiv.org/abs/2206.07682
  4. ^ LeCun, Y., Bengio, Y. og Hinton, G. (2015). Deep learning. Nature, 521, 436–444. https://doi.org/10.1038/nature14539
  5. ^ LeCun, Y. o.fl. (2015).
  6. ^ Goodfellow, I., Bengio, Y. og Courville, A. (2016). Deep Learning. MIT Press. Kafli 5.2, „Capacity, Overfitting and Underfitting“. https://www.deeplearningbook.org/
  7. ^ Yudkowsky, E. og Soares, N. (2025). If Anyone Builds It, Everyone Dies: Why Superhuman AI Would Kill Us All. Little, Brown and Company. https://ifanyonebuildsit.com/
  8. ^ Lindsey, J. o.fl. (2025).
  9. ^ Radford, A., Wu, J., Child, R., Luan, D., Amodei, D. og Sutskever, I. (2019). Language Models are Unsupervised Multitask Learners. Rannsóknarskýrsla, OpenAI. https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
  10. ^ Radford, A. o.fl. (2019).
  11. ^ Templeton, A. o.fl. (2024, 21. maí). Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet. Transformer Circuits Thread, Anthropic. https://transformer-circuits.pub/2024/scaling-monosemanticity/index.html
  12. ^ LeCun, Y. o.fl. (2015).
  13. ^ Ouyang, L. o.fl. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35, 27730–27744. arXiv:2203.02155
  14. ^ Brown, T. B. o.fl. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems, 33, 1877–1901. arXiv:2005.14165
  15. ^ Wei, J. o.fl. (2022). Finetuned Language Models Are Zero-Shot Learners. International Conference on Learning Representations (ICLR 2022). arXiv:2109.01652
  16. ^ Sutskever, I. og Huang, J. (2023, mars). Fireside Chat with Ilya Sutskever and Jensen Huang: AI Today and Vision of the Future. Upptaka af samtali á ráðstefnunni NVIDIA GTC 2023, fyrirlestur S52092. https://www.nvidia.com/en-us/on-demand/session/gtcspring23-s52092/
  17. ^ Garg, S., Tsipras, D., Liang, P. og Valiant, G. (2022). What Can Transformers Learn In-Context? A Case Study of Simple Function Classes. Advances in Neural Information Processing Systems, 35. arXiv:2208.01066
  18. ^ Garg, S. o.fl. (2022).
  19. ^ Pires, T., Schlinger, E. og Garrette, D. (2019). How Multilingual is Multilingual BERT? Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, 4996–5001. arXiv:2208.01066
  20. ^ Lake og Baroni (2023).
  21. ^ Lake og Baroni (2023).
  22. ^ Wunderlich, F. (2026, 19. febrúar). Car Wash Test on 53 leading AI models: “I want to wash my car. The car wash is 50 meters away. Should I walk or drive?” Opper, bloggfærsla. https://opper.ai/blog/car-wash-test
  23. ^ Li, Y., Zhang, L., Jiang, T., Krishnan, R. og Padman, R. (2026). The Model Says Walk: How Surface Heuristics Override Implicit Constraints in LLM Reasoning. Forprentun, arXiv:2603.29025. arXiv:2603.29025
  24. ^ Dell’Acqua, F., McFowland III, E., Mollick, E., Lifshitz-Assaf, H., Kellogg, K. C., Rajendran, S., Krayer, L., Candelon, F. og Lakhani, K. R. (2023). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of AI on Knowledge Worker Productivity and Quality. Harvard Business School Working Paper 24-013. http://dx.doi.org/10.2139/ssrn.4573321
  25. ^ Brown, T. B. o.fl. (2020).
  26. ^ Silver, D. o.fl. (2017). Mastering the game of Go without human knowledge. Nature, 550, 354–359. https://doi.org/10.1038/nature24270
  27. ^ OpenAI (2024). OpenAI o1 System Card. arXiv:2412.16720
  28. ^ Guo, D. o.fl. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645, 633–638. https://doi.org/10.1038/s41586-025-09422-z
  29. ^ OpenAI (2026, 8. september). On the Navier–Stokes Millennium Prize Problem. Tilkynning. https://openai.com/index/navier-stokes-solution/
  30. ^ Kahn, J. (2026, 8. september). OpenAI says it cracked one of math’s grand challenges. But there are troubling questions about how they did it—and what it means for us all. Fortune. https://fortune.com/2026/09/08/openai-says-it-cracked-navier-stokes-math-grand-challenge-buckmaster-accusation-cheating-intimidation-tao-lament/

Myndir:...