Sólin Sólin Rís 07:39 • sest 18:53 í Reykjavík
Tunglið Tunglið Rís 00:00 • Sest 00:00 í Reykjavík
Flóð Flóð Árdegis: 09:52 • Síðdegis: 22:25 í Reykjavík
Fjaran Fjara Árdegis: 03:32 • Síðdegis: 16:14 í Reykjavík
Sólin Sólin Rís 07:39 • sest 18:53 í Reykjavík
Tunglið Tunglið Rís 00:00 • Sest 00:00 í Reykjavík
Flóð Flóð Árdegis: 09:52 • Síðdegis: 22:25 í Reykjavík
Fjaran Fjara Árdegis: 03:32 • Síðdegis: 16:14 í Reykjavík
LeiðbeiningarTil baka

Sendu inn spurningu

Hér getur þú sent okkur nýjar spurningar um vísindaleg efni.

Hafðu spurninguna stutta og hnitmiðaða og sendu aðeins eina í einu. Einlægar og vandaðar spurningar um mikilvæg efni eru líklegastar til að kalla fram vönduð og greið svör. Ekki er víst að tími vinnist til að svara öllum spurningum.

Persónulegar upplýsingar um spyrjendur eru eingöngu notaðar í starfsemi vefsins, til dæmis til að svör verði við hæfi spyrjenda. Spurningum er ekki sinnt ef spyrjandi villir á sér heimildir eða segir ekki nægileg deili á sér.

Spurningum sem eru ekki á verksviði vefsins er eytt.

Að öðru leyti er hægt að spyrja Vísindavefinn um allt milli himins og jarðar!

=

Hvenær og hvar hófst þróun stórra mállíkana?

Hafsteinn Einarsson

Upprunalega spurningin var í nokkrum liðum og hér er fyrri hlutanum svarað:
Hvaðan kemur gervigreind? hvenær var fyrst reynt við hugmyndina, hvar, hvers vegna? Hverjir voru fyrstir til þess að gera hana opna almenningi, var það Chat eða voru aðrir að þjálfa hana til annarra nota en almennings "hjálpar"?

Stór mállíkön (e. large language models, LLMs), eins og þau sem liggja að baki nútímaspjallmennum, eru líkön sem læra mynstur í tungumáli út frá stóru safni texta. Saga þeirra er hluti af sögu gervigreindar, en spjallforrit og önnur gervigreindarkerfi fyrir árið 2017 voru ekki mállíkön af sömu gerð og líkön á borð við ChatGPT.

Stór mállíkön eiga sér langa forsögu og voru bæði rannsökuð og gerð aðgengileg utan rannsóknardeilda tæknifyrirtækja áður en ChatGPT kom fram árið 2022. Þau voru meðal annars þróuð til að vinna með texta, svara spurningum og bæta vélþýðingar, og margar af lykilhugmyndunum að baki þeim urðu einmitt til í rannsóknum á sviði vélþýðinga. ChatGPT gerði fólki auðvelt að eiga samtal við slíkt líkan, en var hvorki fyrsta mállíkanið né fyrsta leið almennings til að prófa þau.

Frá líkum á stöfum til stórra tauganeta

Ein forsenda mállíkana er að tungumál hafi mynstur sem hægt sé að lýsa með líkum. Bandaríski stærðfræðingurinn Claude Shannon setti þá hugmynd fram árið 1948 í greininni „A Mathematical Theory of Communication“. Þar lýsti hann texta sem slembiferli þar sem líkur á næsta staf ráðast af stöfunum á undan, og sýndi hvernig búa má til sífellt raunverulegri eftirlíkingar af ensku með því að taka tillit til lengra samhengis: fyrst eins stafs á undan, svo tveggja og loks heilla orða.[1] Árið 1951 birti hann svo rannsókn þar sem fólk var látið giska á næsta staf í texta til að mæla hve fyrirsjáanleg enska væri.[2] Sú rannsókn var mæling á tungumálinu, ekki líkan, og einföldu tölfræðilíkönin frá 1948 eiga fátt sameiginlegt með tauganetum nútímans. Þau sýna þó að hugmyndin um að spá fyrir um framhald texta er miklu eldri en tæknin á bak við nútímaspjallmenni.
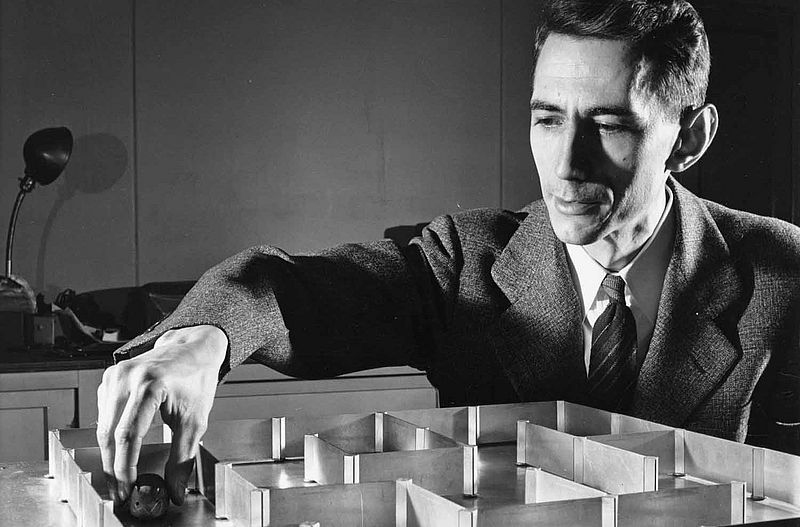
Ein forsenda mállíkana er að tungumál hafi mynstur sem hægt sé að lýsa með líkum. Bandaríski stærðfræðingurinn Claude Shannon setti þá hugmynd fram árið 1948 í greininni „A Mathematical Theory of Communication“.

Ein forsenda mállíkana er að tungumál hafi mynstur sem hægt sé að lýsa með líkum. Bandaríski stærðfræðingurinn Claude Shannon setti þá hugmynd fram árið 1948 í greininni „A Mathematical Theory of Communication“.

Mikilvægur áfangi í þróun mállíkana sem byggjast á tauganetum var greinin „A Neural Probabilistic Language Model“ eftir Yoshua Bengio og samstarfsfólk við Háskólann í Montréal í Kanada árið 2003. Verkefnið var það sama og í eldri tölfræðilíkönum: að spá fyrir um næsta orð út frá tveimur til fimm orðum á undan. Nýja nálgunin var sú að hvert orð fékk tölulega framsetningu, runu af 30 til 100 tölum, sem lærðist um leið og líkanið lærði að spá. Orð með svipaða merkingu og svipað hlutverk í setningum fengu svipaðar tölur. Hugmyndin var sú að hafi líkanið séð setninguna „The cat is walking in the bedroom“ ætti það líka að telja setninguna „A dog was running in a room“ líklega, af því að „cat“ og „dog“ gegna svipuðu hlutverki og eins „bedroom“ og „room“. Það átti að draga úr þörfinni að þurfa að sjá hverja einustu orðasamsetningu.[3]

Líkanið var þjálfað á um einni milljón orða í annarri tilraun greinarinnar og um fjórtán milljónum orða í hinni. Samkvæmt formúlu greinarinnar voru stikar þess, stillanlegu tölugildin sem mótast við þjálfun, á bilinu tvær til tólf milljónir eftir útfærslu. Til samanburðar hafði GPT-3, sem kom fram árið 2020, 175 milljarða stika, meira en tíu þúsund sinnum fleiri, og var þjálfað á um 300 milljörðum tóka, þ.e. orða og orðhluta.[4][5] Líkan Bengios og félaga var því einn af undanförum stórra mállíkana nútímans fremur en afmarkaður „fæðingardagur“ þeirra.

Næstu stóru skrefin komu úr rannsóknum á vélþýðingum. Í september 2014 birtu Dzmitry Bahdanau, Kyunghyun Cho og Yoshua Bengio forprentun greinar, sem kynnt var á ráðstefnunni ICLR árið 2015, þar sem athygliskerfi (e. attention) var kynnt til sögunnar fyrir þýðingarlíkön. Fram að því höfðu slík líkön þjappað allri setningunni sem þýða átti saman í eina talnarunu af fastri lengd, og sú þjöppun var flöskuháls. Með athygliskerfinu gat líkanið þess í stað leitað í upphaflegu setningunni og vegið saman þá hluta hennar sem skiptu máli fyrir hvert orð í þýðingunni.[6]

Árið 2017 kynntu Ashish Vaswani og samstarfsfólk, að mestu hjá Google, greinina „Attention Is All You Need“. Þar var lýst nýrri gerð tauganets, umbreyti (e. transformer), sem byggist eingöngu á athygliskerfum og sleppir eldri gerðum netlaga sem unnu textann orð fyrir orð í röð. Aðferðin var prófuð á þýðingum úr ensku á þýsku og frönsku. Þar sem mun stærri hluta útreikninganna mátti framkvæma samhliða varð auðveldara að þjálfa stærri líkön á meiri texta.[7] Bæði athygliskerfið og umbreytirinn urðu þannig til í rannsóknum á vélþýðingum, og umbreytirinn er grunnurinn sem flest mállíkön byggja á í dag.

Tilvísanir:
  1. ^ Shannon, C. E. (1948). A Mathematical Theory of Communication. The Bell System Technical Journal, 27(3), 379–423. https://ieeexplore.ieee.org/document/6773024
  2. ^ Shannon, C. E. (1951). Prediction and Entropy of Printed English. The Bell System Technical Journal, 30(1), 50–64. https://ieeexplore.ieee.org/document/6773263
  3. ^ Bengio, Y., Ducharme, R., Vincent, P. og Jauvin, C. (2003). A Neural Probabilistic Language Model. Journal of Machine Learning Research, 3, 1137–1155. https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf
  4. ^ Bengio o.fl. (2003).
  5. ^ Brown, T. B. o.fl. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems, 33, 1877–1901. https://arxiv.org/abs/2005.14165
  6. ^ Bahdanau, D., Cho, K. og Bengio, Y. (2015). Neural Machine Translation by Jointly Learning to Align and Translate. International Conference on Learning Representations (ICLR 2015). Forprentun birt á arXiv 1. september 2014 (arXiv:1409.0473). https://arxiv.org/abs/1409.0473
  7. ^ Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł. og Polosukhin, I. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems, 30. https://arxiv.org/abs/1706.03762

Myndir:

Höfundur

Hafsteinn Einarsson

dósent í tölvunarfræði við HÍ

Útgáfudagur

2.10.2026

Spyrjandi

Rebekka Rán

Tilvísun

Hafsteinn Einarsson. „Hvenær og hvar hófst þróun stórra mállíkana?“ Vísindavefurinn, 2. október 2026, sótt 2. október 2026, https://visindavefur.is/svar.php?id=89763.

Hafsteinn Einarsson. (2026, 2. október). Hvenær og hvar hófst þróun stórra mállíkana? Vísindavefurinn. https://visindavefur.is/svar.php?id=89763

Hafsteinn Einarsson. „Hvenær og hvar hófst þróun stórra mállíkana?“ Vísindavefurinn. 2. okt. 2026. Vefsíða. 2. okt. 2026. <https://visindavefur.is/svar.php?id=89763>.

Chicago | APA | MLA

Senda grein til vinar

=

Hvenær og hvar hófst þróun stórra mállíkana?
Upprunalega spurningin var í nokkrum liðum og hér er fyrri hlutanum svarað:

Hvaðan kemur gervigreind? hvenær var fyrst reynt við hugmyndina, hvar, hvers vegna? Hverjir voru fyrstir til þess að gera hana opna almenningi, var það Chat eða voru aðrir að þjálfa hana til annarra nota en almennings "hjálpar"?

Stór mállíkön (e. large language models, LLMs), eins og þau sem liggja að baki nútímaspjallmennum, eru líkön sem læra mynstur í tungumáli út frá stóru safni texta. Saga þeirra er hluti af sögu gervigreindar, en spjallforrit og önnur gervigreindarkerfi fyrir árið 2017 voru ekki mállíkön af sömu gerð og líkön á borð við ChatGPT.

Stór mállíkön eiga sér langa forsögu og voru bæði rannsökuð og gerð aðgengileg utan rannsóknardeilda tæknifyrirtækja áður en ChatGPT kom fram árið 2022. Þau voru meðal annars þróuð til að vinna með texta, svara spurningum og bæta vélþýðingar, og margar af lykilhugmyndunum að baki þeim urðu einmitt til í rannsóknum á sviði vélþýðinga. ChatGPT gerði fólki auðvelt að eiga samtal við slíkt líkan, en var hvorki fyrsta mállíkanið né fyrsta leið almennings til að prófa þau.

Frá líkum á stöfum til stórra tauganeta

Ein forsenda mállíkana er að tungumál hafi mynstur sem hægt sé að lýsa með líkum. Bandaríski stærðfræðingurinn Claude Shannon setti þá hugmynd fram árið 1948 í greininni „A Mathematical Theory of Communication“. Þar lýsti hann texta sem slembiferli þar sem líkur á næsta staf ráðast af stöfunum á undan, og sýndi hvernig búa má til sífellt raunverulegri eftirlíkingar af ensku með því að taka tillit til lengra samhengis: fyrst eins stafs á undan, svo tveggja og loks heilla orða.[1] Árið 1951 birti hann svo rannsókn þar sem fólk var látið giska á næsta staf í texta til að mæla hve fyrirsjáanleg enska væri.[2] Sú rannsókn var mæling á tungumálinu, ekki líkan, og einföldu tölfræðilíkönin frá 1948 eiga fátt sameiginlegt með tauganetum nútímans. Þau sýna þó að hugmyndin um að spá fyrir um framhald texta er miklu eldri en tæknin á bak við nútímaspjallmenni.

Ein forsenda mállíkana er að tungumál hafi mynstur sem hægt sé að lýsa með líkum. Bandaríski stærðfræðingurinn Claude Shannon setti þá hugmynd fram árið 1948 í greininni „A Mathematical Theory of Communication“.

Ein forsenda mállíkana er að tungumál hafi mynstur sem hægt sé að lýsa með líkum. Bandaríski stærðfræðingurinn Claude Shannon setti þá hugmynd fram árið 1948 í greininni „A Mathematical Theory of Communication“.

Mikilvægur áfangi í þróun mállíkana sem byggjast á tauganetum var greinin „A Neural Probabilistic Language Model“ eftir Yoshua Bengio og samstarfsfólk við Háskólann í Montréal í Kanada árið 2003. Verkefnið var það sama og í eldri tölfræðilíkönum: að spá fyrir um næsta orð út frá tveimur til fimm orðum á undan. Nýja nálgunin var sú að hvert orð fékk tölulega framsetningu, runu af 30 til 100 tölum, sem lærðist um leið og líkanið lærði að spá. Orð með svipaða merkingu og svipað hlutverk í setningum fengu svipaðar tölur. Hugmyndin var sú að hafi líkanið séð setninguna „The cat is walking in the bedroom“ ætti það líka að telja setninguna „A dog was running in a room“ líklega, af því að „cat“ og „dog“ gegna svipuðu hlutverki og eins „bedroom“ og „room“. Það átti að draga úr þörfinni að þurfa að sjá hverja einustu orðasamsetningu.[3]

Líkanið var þjálfað á um einni milljón orða í annarri tilraun greinarinnar og um fjórtán milljónum orða í hinni. Samkvæmt formúlu greinarinnar voru stikar þess, stillanlegu tölugildin sem mótast við þjálfun, á bilinu tvær til tólf milljónir eftir útfærslu. Til samanburðar hafði GPT-3, sem kom fram árið 2020, 175 milljarða stika, meira en tíu þúsund sinnum fleiri, og var þjálfað á um 300 milljörðum tóka, þ.e. orða og orðhluta.[4][5] Líkan Bengios og félaga var því einn af undanförum stórra mállíkana nútímans fremur en afmarkaður „fæðingardagur“ þeirra.

Næstu stóru skrefin komu úr rannsóknum á vélþýðingum. Í september 2014 birtu Dzmitry Bahdanau, Kyunghyun Cho og Yoshua Bengio forprentun greinar, sem kynnt var á ráðstefnunni ICLR árið 2015, þar sem athygliskerfi (e. attention) var kynnt til sögunnar fyrir þýðingarlíkön. Fram að því höfðu slík líkön þjappað allri setningunni sem þýða átti saman í eina talnarunu af fastri lengd, og sú þjöppun var flöskuháls. Með athygliskerfinu gat líkanið þess í stað leitað í upphaflegu setningunni og vegið saman þá hluta hennar sem skiptu máli fyrir hvert orð í þýðingunni.[6]

Árið 2017 kynntu Ashish Vaswani og samstarfsfólk, að mestu hjá Google, greinina „Attention Is All You Need“. Þar var lýst nýrri gerð tauganets, umbreyti (e. transformer), sem byggist eingöngu á athygliskerfum og sleppir eldri gerðum netlaga sem unnu textann orð fyrir orð í röð. Aðferðin var prófuð á þýðingum úr ensku á þýsku og frönsku. Þar sem mun stærri hluta útreikninganna mátti framkvæma samhliða varð auðveldara að þjálfa stærri líkön á meiri texta.[7] Bæði athygliskerfið og umbreytirinn urðu þannig til í rannsóknum á vélþýðingum, og umbreytirinn er grunnurinn sem flest mállíkön byggja á í dag.

Tilvísanir:
  1. ^ Shannon, C. E. (1948). A Mathematical Theory of Communication. The Bell System Technical Journal, 27(3), 379–423. https://ieeexplore.ieee.org/document/6773024
  2. ^ Shannon, C. E. (1951). Prediction and Entropy of Printed English. The Bell System Technical Journal, 30(1), 50–64. https://ieeexplore.ieee.org/document/6773263
  3. ^ Bengio, Y., Ducharme, R., Vincent, P. og Jauvin, C. (2003). A Neural Probabilistic Language Model. Journal of Machine Learning Research, 3, 1137–1155. https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf
  4. ^ Bengio o.fl. (2003).
  5. ^ Brown, T. B. o.fl. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems, 33, 1877–1901. https://arxiv.org/abs/2005.14165
  6. ^ Bahdanau, D., Cho, K. og Bengio, Y. (2015). Neural Machine Translation by Jointly Learning to Align and Translate. International Conference on Learning Representations (ICLR 2015). Forprentun birt á arXiv 1. september 2014 (arXiv:1409.0473). https://arxiv.org/abs/1409.0473
  7. ^ Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł. og Polosukhin, I. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems, 30. https://arxiv.org/abs/1706.03762

Myndir:...